策略生成的過度最佳化:別被自己騙了
策略生成得夠多,光靠機率就會有一些看起來很漂亮。搜尋範圍越大,這件事越重要。以下說明怎麼分辨。
AlphaPrime 團隊 ·
為什麼搜尋會製造假贏家
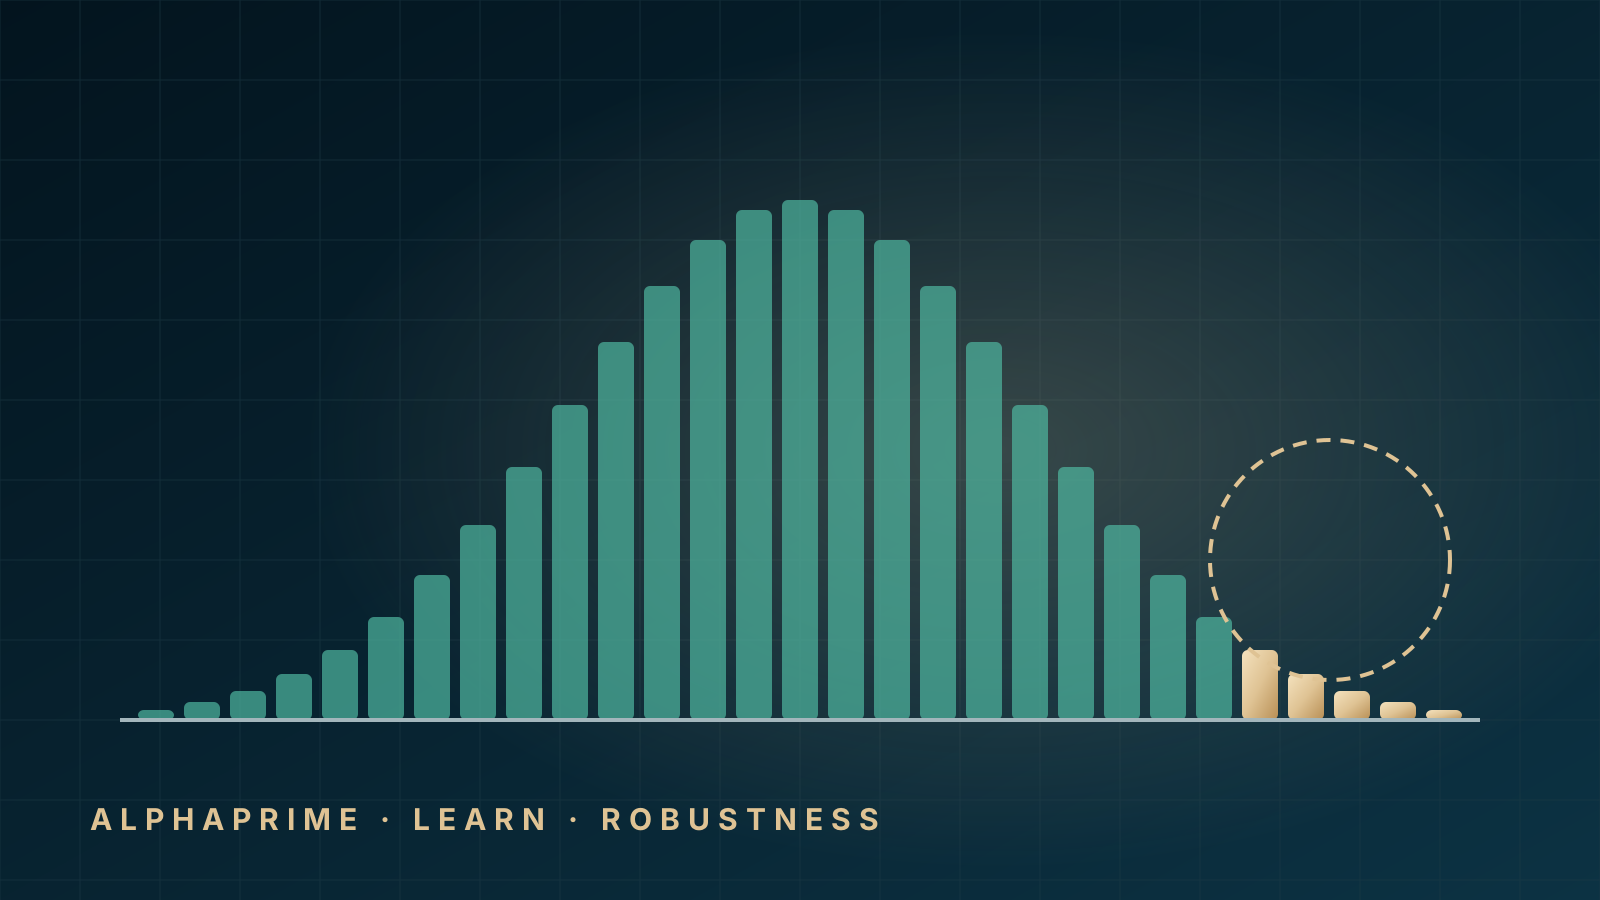
想像有 10,000 個策略,完全沒有真正的優勢。它們的回測結果還是會有高有低,因為市場本身充滿雜訊。其中少數幾個會碰巧出現平滑的權益曲線和亮眼的統計數字。如果你照績效排序、只留前段班,留下來的大多是運氣最好的那幾個。
這就是資料探勘偏差,也叫選擇偏差或多重檢定問題。這不是自動生成才有的問題:交易者在同一張圖上手動試五十個點子,碰到的是一樣的問題,只是規模比較小。自動生成會讓問題變大,因為搜尋的範圍更大。
策略只是在貼合雜訊的跡象
- 一到樣本外,績效就崩掉。這是最明顯的跡象。在建立策略用的資料上表現很強,換到沒看過的資料就普普通通,甚至虧損。
- 參數高峰很尖。回看長度設 17 有效,設 15 或 19 就不行。真實的效應通常會隨參數移動慢慢變弱。
- 條件太多、交易太少。每多加一個濾網,就能從過去的紀錄裡剔掉幾筆虧損交易。濾網加得夠多,任何歷史都能弄得很好看。
- 結果只靠少數幾筆交易。拿掉最好的五筆交易,優勢就不見了。
- 只在單一商品、單一 K 棒週期有效,而且說不出任何道理。
有幫助的檢查方法
1. 保留一段搜尋完全不碰的資料
開始之前就先把歷史資料切好。在其中一段上建立和挑選策略,再用預留的另一段把入圍策略測一次。如果看了預留資料的結果之後,又回頭修改策略,那段資料就不再是「沒看過」的了。推進分析(Walk-Forward)把這個概念再延伸:在許多連續、沒看過的區間上,測試一套重新調參數的流程。
2. 搜尋範圍越大,標準要拉越高
測的候選越多,最好的那一個光靠運氣就會看起來越好。試 10 次得到的亮眼結果,換成試 100,000 次,可能只是意料中的事。記下總共生成並測試了多少策略;搜尋範圍大的時候,對入圍策略的要求就要更高。
3. 測穩定性,不要只看最佳點
用相近的參數值、稍微不同的起始日期,以及在價格上加入少量雜訊,把入圍策略再跑一次。穩健的策略會慢慢變差;只是貼合歷史的策略會整個垮掉。
4. 對交易序列做蒙地卡羅
把策略的交易重新洗牌或重新抽樣,看看同樣這些交易換個順序,可能出現多大範圍的回撤。歷史回撤只是其中一條路徑,整個分布才告訴你該做好什麼準備。
5. 跟隨機策略比較
在同樣的設定下,用隨機進場生成一批策略,看看你的入圍策略跟這個分布比起來如何。如果最好的隨機策略看起來跟你的一樣好,代表這次搜尋除了雜訊,什麼都沒找到。
6. 一開始就算進合理的成本
很多帳面上好看、其實勉強及格的策略,一算進成本就被淘汰了。在搜尋過程中就納入成本,而不是最後才算,可以避免搜尋偏向高頻的雜訊。請參考回測中的交易成本。
實用的工作流程
- 生成任何策略之前,先決定資料怎麼切、成本模型和篩選標準。
- 在樣本內資料上生成和篩選,門檻設保守一點。
- 對留下來的策略跑穩定性和蒙地卡羅檢查。
- 對剩下的策略跑推進分析。
- 最後幾個策略,用預留資料測一次。
- 寫下整個流程總共測了多少個候選策略。
這些步驟沒有一個能證明策略未來一定有效。但合在一起,可以大幅降低一種可能:你找到的,只是大規模搜尋裡運氣最好的那個結果。
AlphaPrime 在這裡能幫上什麼
AlphaPrime 的策略檢驗讓你自訂門檻,執行基礎、標準或完整三種檢查(包含推進分析);策略沒通過前面的檢查,就不再跑後面的檢查。GPU 回測讓你把更多時間留給這些檢查。